
Co si z článku odnést
- Log je záznam toho, co server opravdu vrátil. Search Console i crawler ukazují jen část obrazu.
- User-agent nestačí. Googlebota ověříte reverzním a dopředným DNS nebo podle oficiálních rozsahů IP.
- AI boti mají oddělené role: trénink, vyhledávací index a fetch na pokyn uživatele. Každou řídíte zvlášť.
- Robots.txt dodržují jen slušní boti. Jestli pravidla fungují, ověříte zase jen v logu.
Proč logy ukážou víc než Search Console
Logy samy pozice nezlepší. Ukážou ale, jestli se obsah vůbec dá najít a zpracovat, a to je podmínka všeho ostatního. Search Console v přehledu Statistiky procházení nabízí agregovaná čísla a vzorek adres. Crawler typu Screaming Frog projde odkazy jako robot, ale neví, kam robot opravdu chodí. Access log je jediný zdroj, ve kterém je každý požadavek s časem, adresou a odpovědí serveru.
Od roku 2025 má log ještě jednu roli: je to nejspolehlivější místo, kde uvidíte AI boty. Žádný z provozovatelů AI vyhledávání vám nenabízí obdobu Search Console, takže kolik stránek si GPTBot nebo ClaudeBot stáhl a jakou dostal odpověď, zjistíte jen ze serveru nebo z CDN.
| Otázka | Serverové logy | GSC Statistiky procházení | Crawler (např. Screaming Frog) |
|---|---|---|---|
| Kam Googlebot skutečně chodí | Ano, každý požadavek | Částečně, vzorek a souhrny | Ne, jen co je dosažitelné |
| AI boti a další vyhledávače | Ano | Ne | Ne |
| Falešní boti | Ano, po ověření IP | Ne | Ne |
| Osiřelé stránky bez odkazů | Ano, pokud je robot navštěvuje | Ne | Ne |
| Historie | Podle vaší retence | Zhruba 90 dní | Jen okamžik procházení |
Zdroje: t3n: Logfile-Analysen im SEO; Google: přehled Statistiky procházení v Search Console
Co obsahuje access log a kde ho najdete
Nginx i Apache standardně zapisují řádky ve formátu combined. Každý řádek je jeden požadavek: kdo přišel, kdy, na jakou adresu, co server odpověděl a čím se klient představil. Pro SEO jsou důležité hlavně adresa, stavový kód a user-agent. Boti obvykle neposílají referrer, protože na URL jdou přímo ze svého seznamu.
Doplňte si do formátu logu i dobu zpracování požadavku. V Nginx je to proměnná request_time, v Apache direktiva %D. Bez ní nezjistíte, jestli Googlebot nechodí méně právě proto, že mu server odpovídá pomalu.
- Vlastní server nebo VPS: obvykle /var/log/nginx/access.log nebo /var/log/apache2/access.log, starší dny bývají zabalené logrotate.
- Docker: kontejner s Nginx často zapisuje na standardní výstup, logy pak čtete přes docker logs nebo je posíláte do centrálního úložiště.
- Sdílený hosting: logy bývají ke stažení v administraci, často jen za několik posledních dní. Ověřte si, kolik dní hosting drží.
- CDN: pokud web běží za Cloudflare, část požadavků origin vůbec neuvidí. Kompletní data získáte z logů CDN, u Cloudflare přes Logpush.
66.249.66.1                      IP adresa klienta
[12/Mar/2026:10:15:22 +0100]     čas požadavku
"GET /kategorie/boty/ HTTP/2.0"  metoda, adresa, protokol
200                              stavový kód
18432                            velikost odpovědi v bajtech
"-"                              referrer (boti ho obvykle neposílají)
"Mozilla/5.0 (compatible;        user-agent
 Googlebot/2.1; +http://www.google.com/bot.html)"
Logy a GDPR: IP adresa je osobní údaj
Soudní dvůr EU v roce 2016 potvrdil, že i dynamická IP adresa může být osobním údajem. Access log proto spadá pod GDPR, i když v něm hledáte jen roboty. Uchovávání logů lze obvykle opřít o oprávněný zájem, typicky bezpečnost a provoz webu, ale potřebuje jasnou dobu uchování a zmínku v zásadách zpracování osobních údajů.
V praxi se osvědčuje držet surové logy krátce, řádově desítky dní, a pro dlouhodobé srovnání ukládat jen agregace nebo záznamy robotů po ověření. Anonymizaci IP adres provádějte až po ověření botů. Ze zkrácené adresy už Googlebota neověříte.
Zdroj: Soudní dvůr EU: rozsudek C-582/14 Breyer o IP adresách
Co z logů vyčíst pro SEO
Kam Googlebot chodí a kam ne
Porovnejte adresy z logu se sitemapou a s výstupem crawleru. Důležité stránky bez návštěvy robota mají problém s odkazy nebo s kvalitou. Adresy, které robot navštěvuje, ale crawler je nenašel, jsou osiřelé stránky nebo staré URL.
Kde se plýtvá crawlem
Parametry, řazení, filtry a kombinace fasetové navigace dokážou spotřebovat většinu požadavků Googlebota. Seskupte adresy podle šablony a podívejte se, kolik požadavků jde na stránky, které nechcete mít v indexu.
Stavové kódy, které vidí roboti
Chyby 5xx by měly být u nuly, protože Google při nich procházení zpomaluje. Sledujte i 404 a 410 na adresách, které robot stále navštěvuje, a řetězce přesměrování, na které vedou interní odkazy.
Rychlost odpovědi pro roboty
Pomalá odpověď serveru snižuje kapacitu procházení. Porovnejte dobu zpracování pro boty a pro lidi a podívejte se, které šablony jsou nejpomalejší. U e-shopů to bývá vyhledávání a filtrované kategorie.
Dopad změn a migrací
Po nasazení nové verze nebo přesměrování uvidíte v logu během hodin, jestli robot dostává správné odpovědi. Search Console stejnou informaci ukáže se zpožděním několika dní.
Crawl budget: kolik požadavků přijde vniveč
Crawl budget řeší hlavně weby s desítkami tisíc a více adres, typicky e-shopy s filtry. Google o něm mluví jako o kombinaci kapacity serveru a poptávky po obsahu. Pokud se robot zdržuje na nekonečných kombinacích parametrů, dostane se k novým produktům později.
Podle Crawl Waste Report 2026 od SEOmatoru, který vychází z dat Cloudflare Radar, končí stavem 200 jen 45,9 % požadavků crawlerů. Zbytek tvoří přesměrování, chyby a nezměněné odpovědi. Velké weby mají přitom i přes 10 milionů přístupů Googlebota měsíčně, takže je v textovém souboru nezpracujete a potřebujete databázi.
Zdroje: Google: správa crawl budgetu u velkých webů; SEOmator: Crawl Waste Report 2026
Jak ověřit, že jde opravdu o Googlebota
User-agent si může nastavit kdokoli. Scrapery a nástroje konkurence se za Googlebota vydávají běžně, aby obešly ochranu webu. Než z logu začnete dělat závěry, oddělte ověřené roboty od falešných. Google popisuje dva oficiální postupy.
- Reverzní DNS: zjistěte hostname k IP adrese z logu.
- Hostname musí končit na googlebot.com, google.com nebo googleusercontent.com podle typu robota.
- Dopředné DNS: přeložte hostname zpět na IP. Musí vyjít původní adresa z logu.
- Hromadně: porovnejte IP s rozsahy, které Google publikuje v JSON souborech common-crawlers, special-crawlers a user-triggered-fetchers. Rozsahy se mění, stahujte je pravidelně.
$ host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer
  crawl-66-249-66-1.googlebot.com.

$ host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1AI boti: trénink, vyhledávání a fetch na pokyn uživatele
AI boti nejsou jeden blok. Velcí provozovatelé mají zvlášť robota pro trénink modelů, zvlášť pro vlastní vyhledávací index a zvlášť pro načtení stránky ve chvíli, kdy se na ni ptá uživatel. Každý se řídí vlastním tokenem v robots.txt, takže můžete trénink odmítnout a citace v AI vyhledávání si ponechat.
Pro audit robots.txt se hodí vědět i o zastaralých tokenech. Anthropic už nepoužívá Claude-Web ani anthropic-ai, pravidla pro ně tedy nic neřídí. Google-Extended není samostatný robot, jen token: rozhoduje o použití obsahu pro trénink a grounding modelů Gemini, ale nemá vliv na procházení Googlebotem ani na AI přehledy ve vyhledávání.
| Provozovatel | Trénink modelů | Vyhledávání a index | Fetch na pokyn uživatele |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Google-Extended (token) | Googlebot | Uživatelské fetchery Googlu | |
| Perplexity | – | PerplexityBot | Perplexity-User |
| Common Crawl | CCBot | – | – |
| ByteDance | Bytespider | – | – |
Zdroje: OpenAI: přehled robotů GPTBot, OAI-SearchBot a ChatGPT-User; Anthropic: ClaudeBot, Claude-SearchBot a Claude-User; Google: přehled běžných robotů včetně tokenu Google-Extended
Kolik AI boti berou a kolik vracejí
Poměr crawl-to-referral říká, kolik stránek bot stáhne na jednoho návštěvníka, kterého platforma pošle zpět na web. U Googlu jde o jednotky, u AI platforem o stovky až tisíce. Čísla z Cloudflare Radar se mezi měsíci výrazně mění, proto je berte jako řád, ne přesnou hodnotu.
Podle stejného zdroje slouží 46,7 % požadavků AI crawlerů k tréninku a jen 11 % živému vyhledávacímu indexu. Proto dává smysl rozhodovat o tréninku a vyhledávání odděleně. GPTBot je podle analýz robots.txt nejčastěji blokovaný AI crawler.
| Provozovatel | Stránek na 1 návštěvu | Období |
|---|---|---|
| zhruba 5 | červen 2026 | |
| Perplexity | zhruba 186 | červen 2026 |
| OpenAI | zhruba 848 | červen 2026 |
| Anthropic | zhruba 2 299 | 28 dní do 19. 7. 2026 |
Zdroje: Technology Checker: statistiky provozu robotů 2026; SEOmator: SEO Benchmarks Report; SEOmator: Crawl Waste Report 2026; Technology Checker: blokování AI crawlerů v robots.txt
Tři profily robots.txt pro AI boty
Než začnete psát pravidla, odpovězte si na dvě otázky: chcete, aby vás AI nástroje citovaly a posílaly návštěvníky? A souhlasíte s tím, že se z obsahu budou trénovat modely? Většině firemních webů a e-shopů vychází první profil: citace ano, trénink ne.
U OpenAI platí, že web vyřazený pro OAI-SearchBot se ve vyhledávacích odpovědích ChatGPT nezobrazí, nanejvýš jako navigační odkaz. Zákaz GPTBota naopak viditelnost v ChatGPT vyhledávání neovlivní. Anthropic podporuje i nestandardní direktivu Crawl-delay, pokud potřebujete boty zpomalit.
# Trénink modelů – zakázat
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: CCBot
User-agent: Bytespider
Disallow: /

# Vyhledávací a uživatelské boty nechte bez omezení:
# OAI-SearchBot, ChatGPT-User, Claude-SearchBot,
# Claude-User, PerplexityBot, Perplexity-User| Token | 1) Citace ano, trénink ne | 2) Maximální viditelnost | 3) Plná blokace |
|---|---|---|---|
| GPTBot, ClaudeBot, CCBot, Bytespider | Zakázat | Povolit | Zakázat |
| Google-Extended | Zakázat | Povolit | Zakázat |
| OAI-SearchBot, Claude-SearchBot, PerplexityBot | Povolit | Povolit | Zakázat |
| ChatGPT-User, Claude-User, Perplexity-User | Povolit | Povolit | Zakázat |
| Googlebot | Povolit | Povolit | Povolit, jinak zmizíte z Googlu |
Zdroje: OpenAI: přehled robotů GPTBot, OAI-SearchBot a ChatGPT-User; Anthropic: ClaudeBot, Claude-SearchBot a Claude-User
Kde robots.txt nestačí: CDN, WAF a ověření IP
Robots.txt je prosba, ne zámek. Dodržují ho slušní boti, zbytek se řeší ve firewallu podle ověřených IP adres a omezením počtu požadavků. Pozor na opačný směr: Anthropic upozorňuje, že při blokaci jeho IP adres se bot nemusí dostat ani k robots.txt, a opt-out pak nefunguje spolehlivě.
Cloudflare od 1. 7. 2026 nabízí všem zákazníkům včetně bezplatného tarifu tři samostatné přepínače: Search, Agent a Training. Googlebot je tam veden jako víceúčelový robot, takže plošná blokace kategorie Training bez výjimky může odříznout i Google. U domén připojených od 15. 9. 2026 jsou navíc tréninkoví a agentní crawleři ve výchozím stavu blokovaní na stránkách s reklamou.
Po každé změně pravidel se vraťte do logu. Ověřte, že zakázaní boti dostávají jen robots.txt, povolení stále dostávají stav 200 a že CDN neodmítá vyhledávací boty, o kterých jste rozhodli, že je chcete pustit. Návštěvy z ChatGPT, Claude nebo Perplexity pak sledujte v analytice jako samostatný zdroj návštěvnosti.
Zdroje: Anthropic: ClaudeBot, Claude-SearchBot a Claude-User; DEV: přepínače Search, Agent a Training v Cloudflare; PPC Land: poměr crawl-to-referral u AI platforem; Cloudflare: nové možnosti řízení AI provozu pro všechny zákazníky
Nástroje: od příkazové řádky po ClickHouse
Screaming Frog Log File Analyser
Nejrychlejší start pro SEO. Ověří boty podle DNS, ukáže nejvíc a nejméně procházené adresáře i přesměrování, která roboti vidí. Zdarma do 1 000 událostí, plná licence stojí 99 £ ročně.
GoAccess
Open-source nástroj pro terminál i HTML report. Hodí se na rychlý přehled user-agentů, stavových kódů a nejnavštěvovanějších adres přímo na serveru, bez exportu dat.
ClickHouse nebo BigQuery
Pro weby s miliony řádků měsíčně. Logy se průběžně nahrávají do databáze a dotazy nad celým rokem trvají sekundy. Na takové databázi lze postavit i měsíční report s trendy procházení.
Vlastní skript
Pro jednorázovou kontrolu stačí awk, grep a sort. Rozšířený skript může ověřovat IP proti JSON rozsahům Googlu a OpenAI a výsledky ukládat do databáze.
# Nejčastější user-agenti
awk -F'"' '{print $6}' access.log | sort | uniq -c | sort -rn | head -20

# Googlebot: nejčastěji procházené adresáře
grep 'Googlebot' access.log | awk '{print $7}' | cut -d/ -f2 \
  | sort | uniq -c | sort -rn | head

# Stavové kódy pro AI boty
grep -E 'GPTBot|ClaudeBot|OAI-SearchBot|PerplexityBot' access.log \
  | awk '{print $9}' | sort | uniq -c
Zdroje: Screaming Frog: Log File Analyser; GoAccess: analýza webových logů v reálném čase
Jak logy vyhodnocuji v praxi: vlastní nástroj
Obecné nástroje ukážou, co je v logu. Pro klienty ale potřebuji vědět hlavně to, co se změnilo a kde je problém. Proto používám vlastní vyhodnocovací nástroj postavený nad serverovými logy, který průběžně hlídá dvě věci: chyby a cesty robotů po webu.
U chyb nesleduji jen jejich počet. Nástroj ukáže, které adresy a šablony chybu vracejí, od kdy a kterému robotovi. Je rozdíl, jestli 404 dostává jen návštěvník ze starého odkazu, nebo Googlebot na stránce, kterou máte v sitemapě.
U cest sleduji, kudy Googlebot a AI boti web procházejí: které sekce navštěvují, kde utrácejí nejvíc požadavků a které důležité stránky naopak vynechávají. Z toho je vidět, jestli robot najde nové produkty a články, nebo se ztrácí ve filtrech a parametrech.
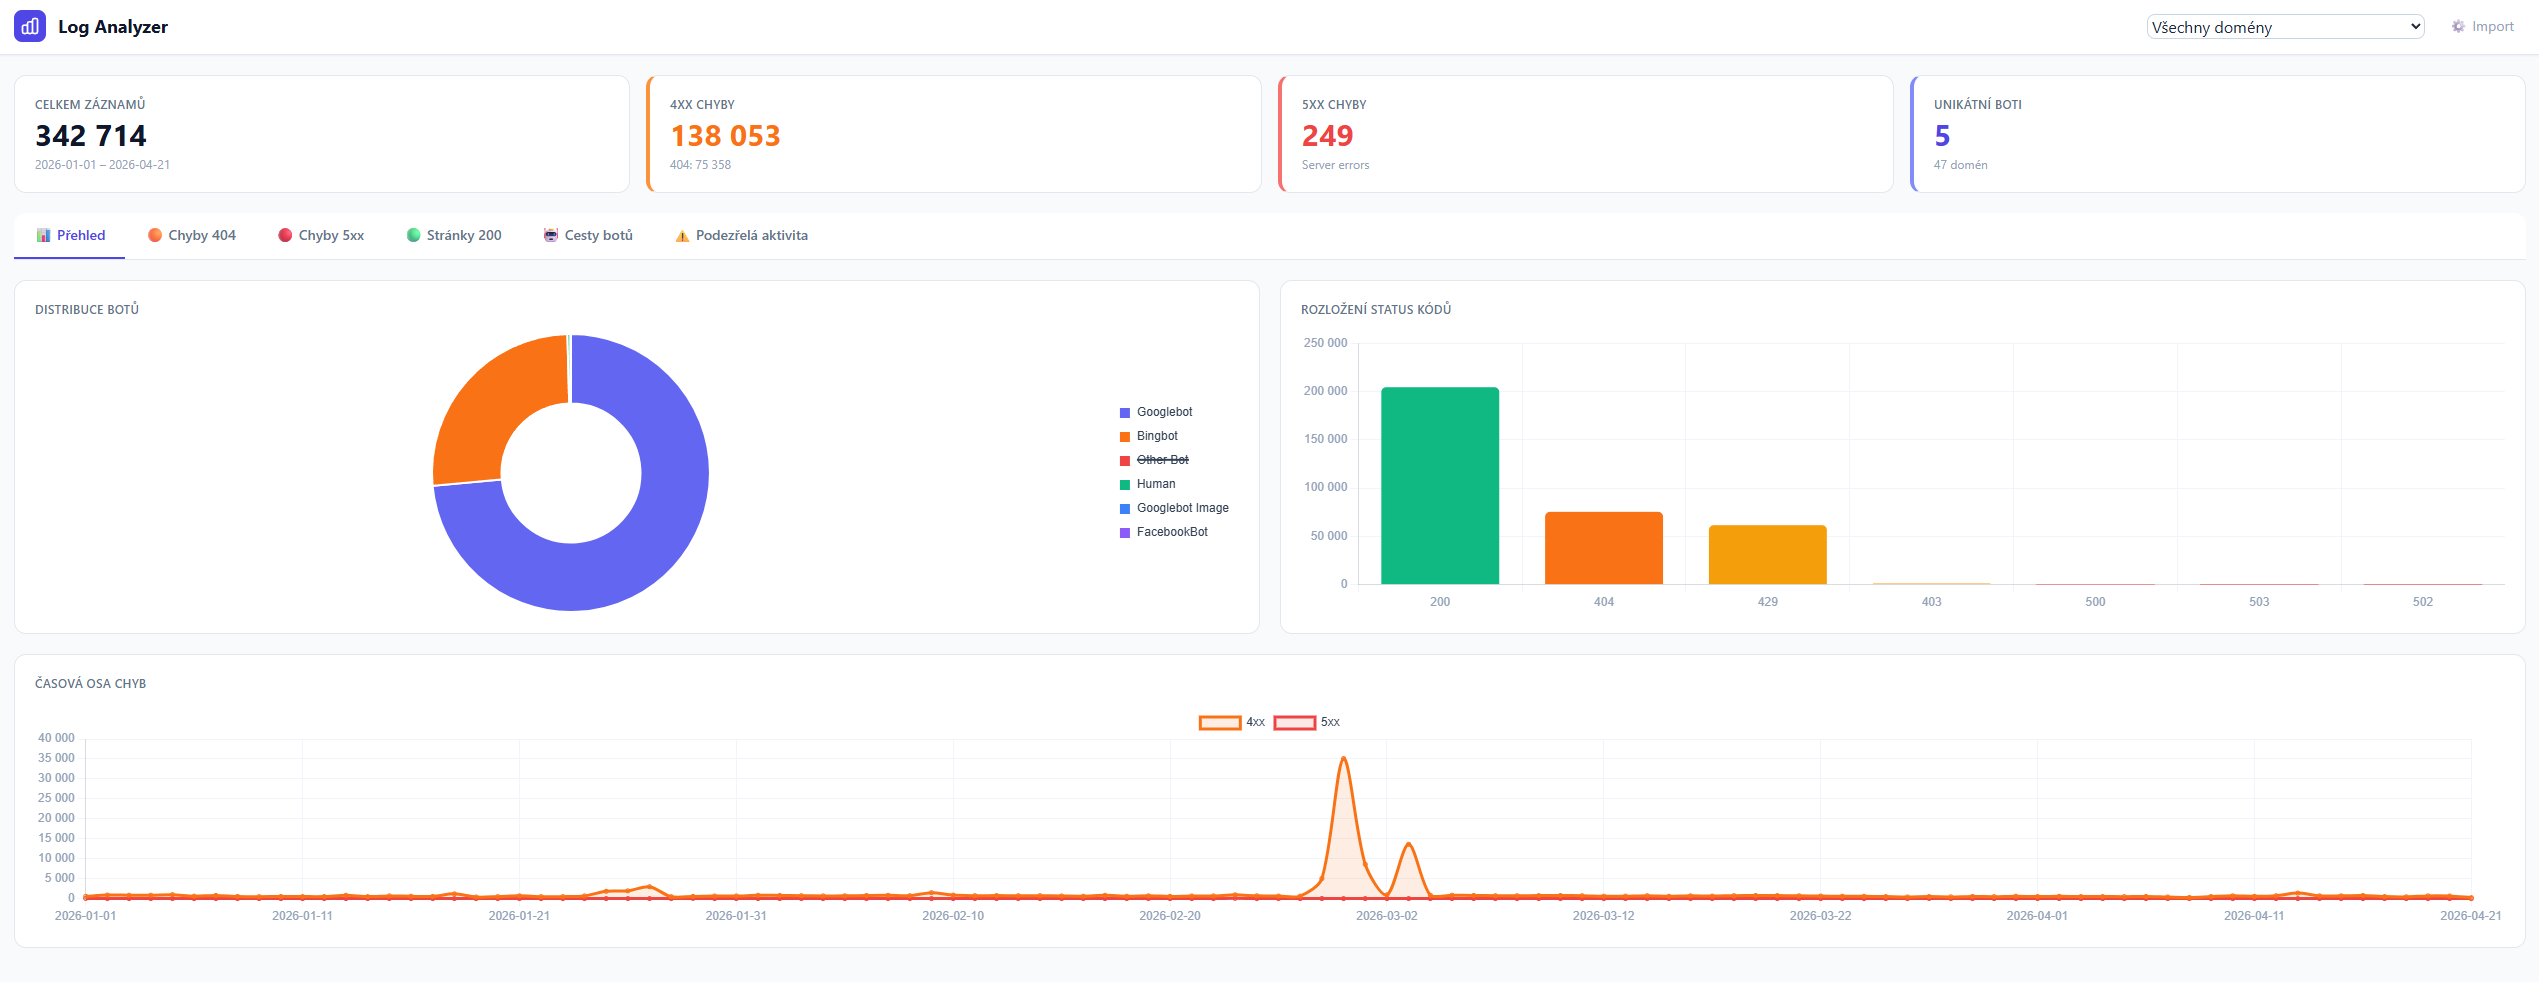
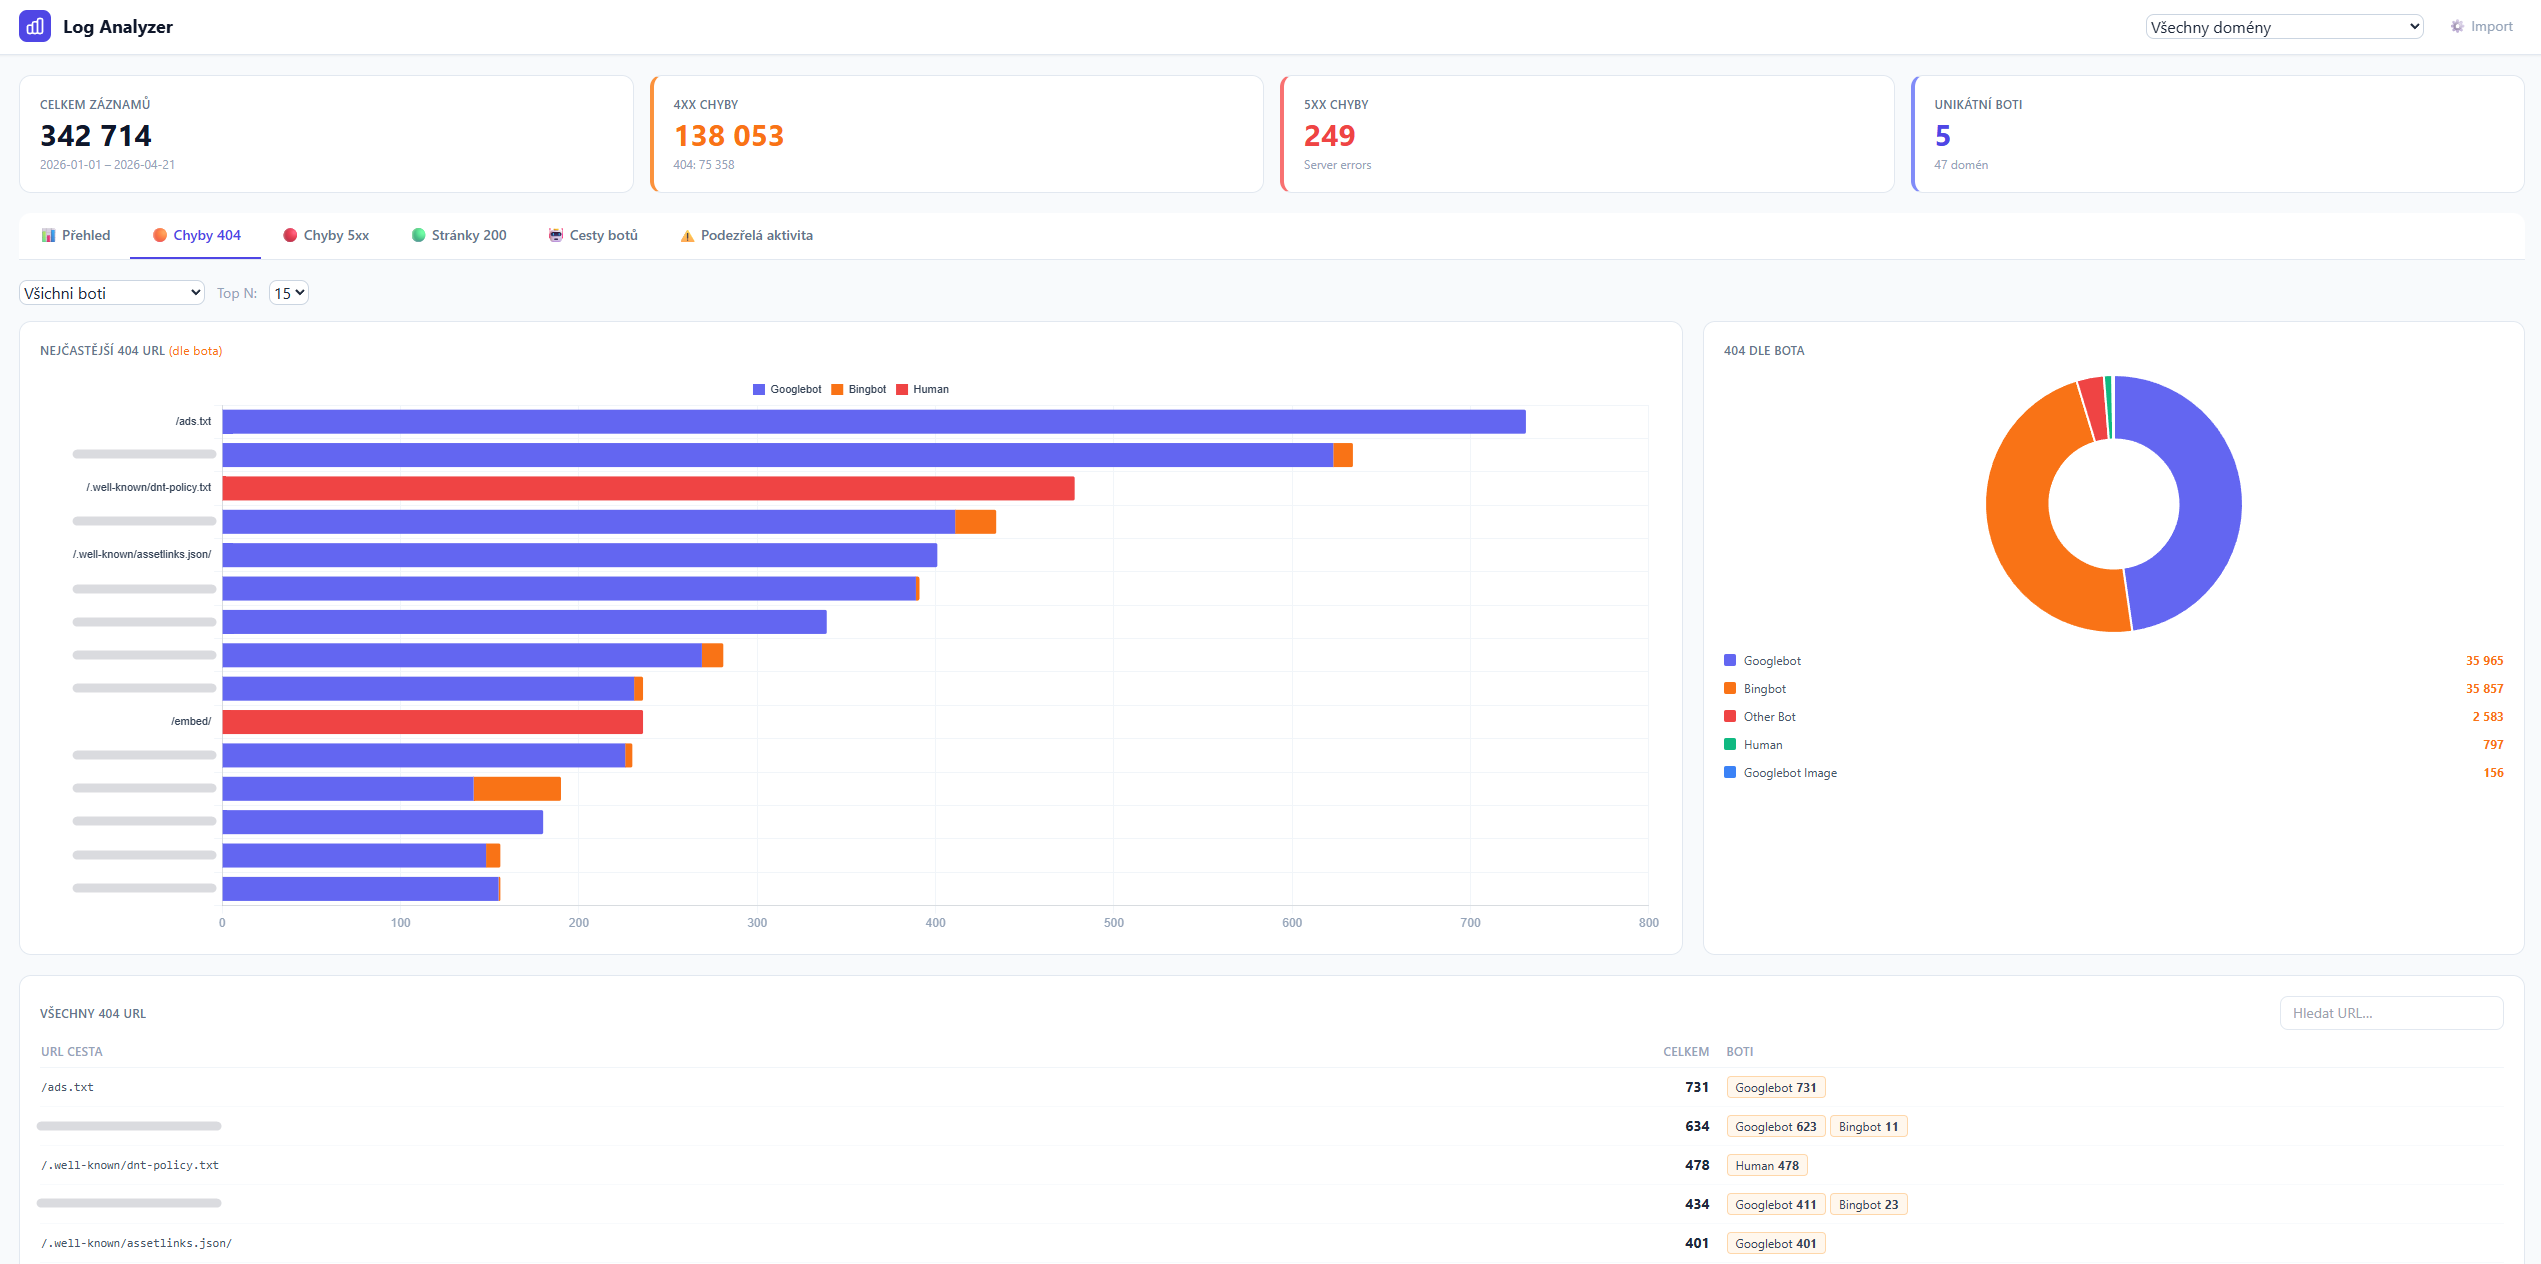
Na snímcích je e-shop provozovaný na 47 doménách. Od 1. 1. do 21. 4. 2026 nástroj zpracoval 342 714 záznamů. Chyb 4xx bylo 138 053, z toho 75 358 stavů 404, chyb 5xx jen 249. Nejčastější 404 pro Googlebota byl soubor /ads.txt, další mířily na staré adresy stránek výrobců. Na časové ose je vidět vlna chyb na začátku března, kterou by měsíční souhrn snadno přešel.
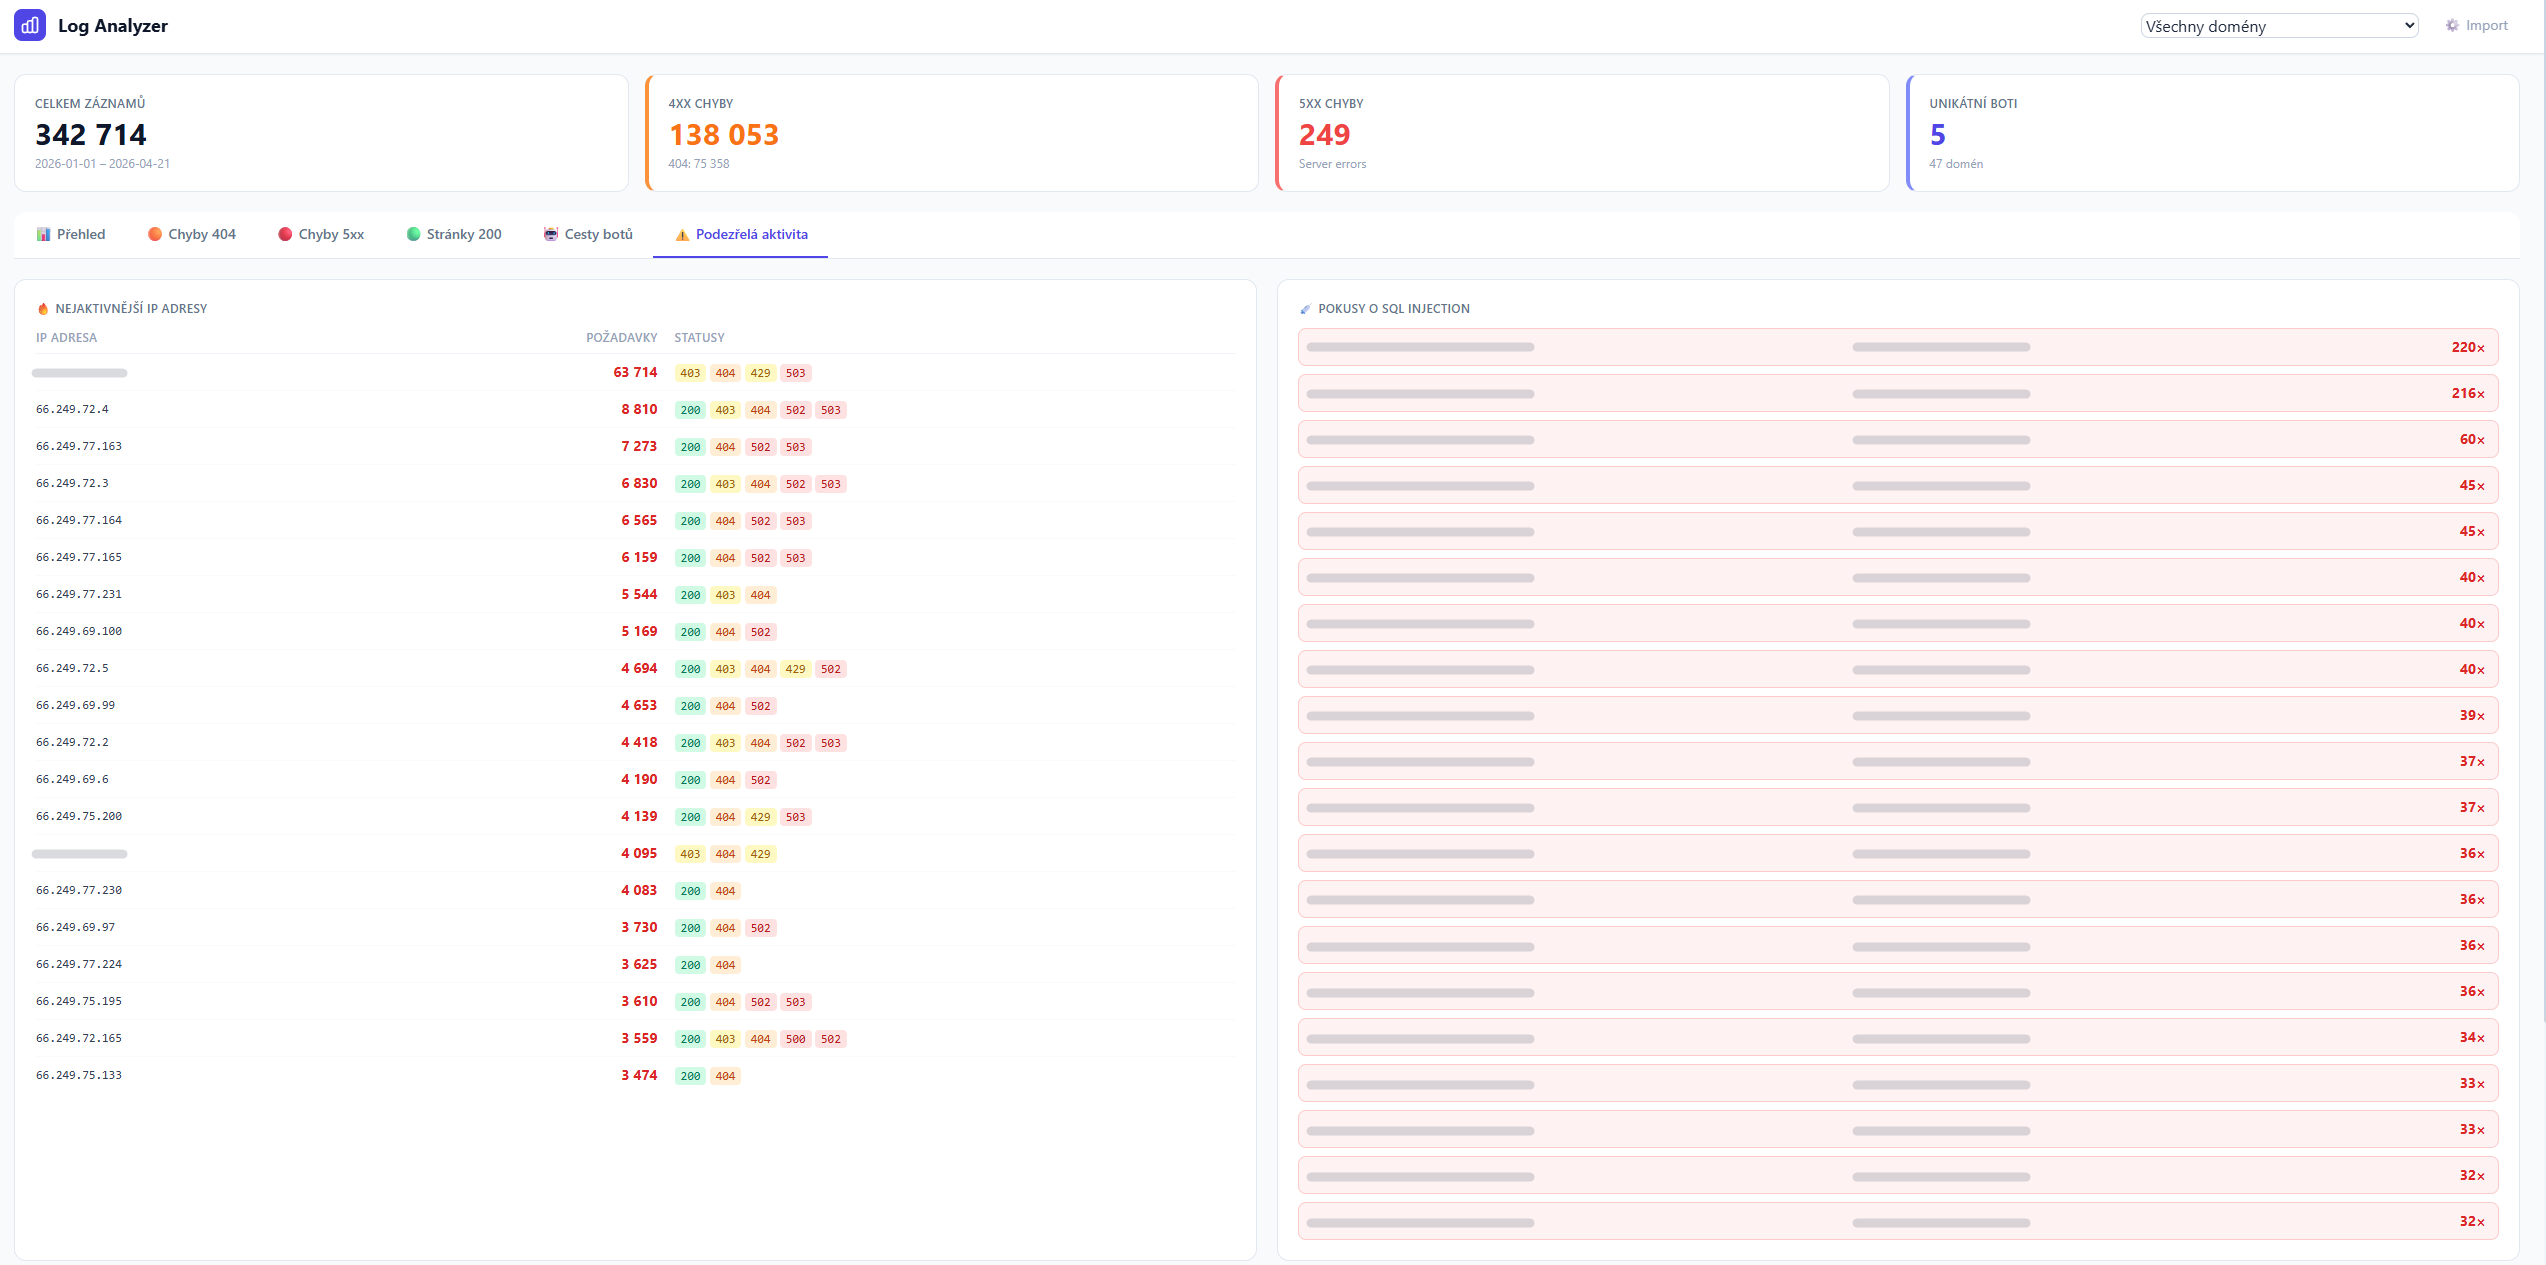
Záložka podezřelé aktivity řadí IP adresy podle počtu požadavků. Na prvním místě byla adresa mimo rozsahy Googlu s 63 714 požadavky, které server odmítal stavy 403 a 429. Hned pod ní ale byly adresy z rozsahu Googlebota, které také dostávaly 429 a občas 502 nebo 503. Ochrana proti přetížení tak brzdila i robota, kterého e-shop potřebuje. Nástroj vedle toho vypisuje pokusy o SQL injection.
Měsíční kontrola logů v deseti bodech
- Logy za poslední měsíc jsou kompletní, včetně požadavků zachycených CDN.
- Googlebot je ověřený přes DNS nebo JSON rozsahy, falešné požadavky jsou vyřazené.
- Podíl chyb 5xx pro boty je u nuly, případné výkyvy mají známou příčinu.
- Adresy s 404 a 410, které robot stále navštěvuje, mají přesměrování nebo opravený odkaz.
- Interní odkazy nevedou přes řetězce přesměrování.
- Podíl požadavků na filtry, parametry a řazení neroste.
- Důležité stránky a nové produkty navštívil Googlebot v posledních dnech.
- Doba odpovědi serveru pro boty se nezhoršila.
- AI boti dostávají odpovědi podle zvoleného profilu robots.txt a nastavení CDN.
- Robots.txt neobsahuje zastaralé tokeny a nepředpokládá chování, které boti nedodržují.
Časté otázky
Co je Googlebot?
Googlebot je robot, kterým Google prochází web a stahuje stránky do svého indexu. Existuje ve verzi pro mobil a pro počítač, většinu webů dnes prochází mobilní varianta. V logu ho poznáte podle user-agentu, jistotu ale dá až ověření IP adresy.
Jak ověřím, že IP adresa z logu patří Googlebotu?
Udělejte reverzní DNS dotaz na IP adresu. Hostname musí končit na googlebot.com, google.com nebo googleusercontent.com. Pak hostname přeložte zpět a musí vyjít původní IP. Pro hromadné ověření použijte JSON rozsahy IP, které Google publikuje.
Zmizí můj web z ChatGPT, když zablokuji GPTBot?
Ne. GPTBot sbírá data pro trénink modelů. Za vyhledávání v ChatGPT odpovídá OAI-SearchBot a za načtení stránky na pokyn uživatele ChatGPT-User. Pokud chcete v ChatGPT zůstat vidět, nechte tyto dva povolené.
Zablokuje Google-Extended AI přehledy v Googlu?
Ne. Google-Extended rozhoduje jen o použití obsahu pro modely Gemini. Procházení Googlebotem, běžné výsledky ani AI přehledy neovlivní. Stránku z AI přehledů lze vyřadit jen nástroji, které omezují i běžné zobrazení ve vyhledávání.
Jak dlouho mám logy uchovávat?
Pro SEO stačí surové logy za několik týdnů, delší historii držte v agregované podobě. IP adresa je osobní údaj, takže dobu uchování stanovte předem a uveďte ji v zásadách zpracování osobních údajů.
Potřebuji na analýzu logů placený nástroj?
Nepotřebujete. Pro menší web stačí příkazová řádka nebo bezplatné nástroje jako GoAccess a zkušební verze Screaming Frog Log File Analyser. Placené řešení nebo databáze se vyplatí až u webů s miliony požadavků měsíčně.
Zdroje a další čtení
- Google: ověření požadavků od robotů a rozsahy IP
- Google: správa crawl budgetu u velkých webů
- Google: přehled Statistiky procházení v Search Console
- OpenAI: přehled robotů GPTBot, OAI-SearchBot a ChatGPT-User
- Anthropic: ClaudeBot, Claude-SearchBot a Claude-User
- Google: přehled běžných robotů včetně tokenu Google-Extended
- SEOmator: Crawl Waste Report 2026
- SEOmator: SEO Benchmarks Report
- Technology Checker: statistiky provozu robotů 2026
- Technology Checker: blokování AI crawlerů v robots.txt
- PPC Land: poměr crawl-to-referral u AI platforem
- DEV: přepínače Search, Agent a Training v Cloudflare
- t3n: Logfile-Analysen im SEO
- Soudní dvůr EU: rozsudek C-582/14 Breyer o IP adresách
- Cloudflare: nové možnosti řízení AI provozu pro všechny zákazníky
- Screaming Frog: Log File Analyser
- GoAccess: analýza webových logů v reálném čase